繼 9 月底僅向資安防禦夥伴小規模預覽後,Google DeepMind 於 10 月 13 日宣布旗艦推理模型 Gemini 4 Argon 向全球 AI Pro、AI Ultra 訂閱戶與付費 API 全面開放。單次輸出上限拉升至 100 萬 Token,在商業代理與低幻覺率(15%)奪冠,但終端機任務仍落後對手,單題平均 6.2 萬 Token 的思考消耗與 Antigravity 隱藏的「5 天週額度鎖定」更成為工程團隊導入前必須算清的現實帳。
Gemini 4 Argon 是 Google DeepMind 推出的新一代旗艦級前沿推理模型(Frontier Reasoning Model),專為長時程(Long-Horizon)、多步驟的複雜軟體工程、企業知識工作(金融、法律、稅務)、科學研究與資安防禦任務所設計,並將單次輸出上限從前代的 6.4 萬(64K)大幅拉升至業界最高的 100 萬(1M)Token(Google 官方部落格 09-30;Google 官方部落格 10-13)。若想回顧 9 月 30 日首波發表當下的背景與初期反應,可先閱讀本系列同作——前篇:Gemini 4 Argon 發表篇。
在產品線定位上,Google 先前取消了 Gemini 3.5 Pro 並將重心轉向主打高速與日常代理任務的工作馬模型 Gemini 3.8 Flash,而 Gemini 4 Argon 則採用全新命名體系,定位在 Gemini 3.8 Flash 與既有 Gemini 3.1 Pro 之上,成為專攻最高難度深層推理的頂規旗艦(9to5Google 09-30;9to5Google 10-13;Gemini API 定價頁)。
自 2026 年 10 月 13 日起,一般對話端(Gemini App 與 Google Search AI Mode)正式開放給 Google AI Pro 與 Google AI Ultra 訂閱戶使用;但在代理開發環境 Google Antigravity(桌面端與 CLI)、Google AI Studio(訂閱制配額)與 Android Studio Canary 中,則強制限定 Google AI Ultra 訂閱戶(美國月費 99.99 美元起,台灣月費 NT$3,300 起)使用,開發者與企業亦可透過 Gemini API 付費層(Paid Tier)與 Vertex AI 平台直接串接。API 採 Token 計價且不提供免費層,2026 年 11 月 30 日前享早鳥推廣價每百萬輸入 Token 2 美元、每百萬輸出 Token(含推理思考 Token)10 美元(快取輸入享 95% 折扣即每百萬 Token 0.10 美元),2026 年 12 月 1 日起恢復標準價每百萬輸入 4 美元、輸出 20 美元。
相較於 9 月 30 日首波發表時僅限 Fairwind 計畫的資安防禦夥伴與極少數測試者存取,10 月 13 日的全球開放讓外界終於能完整檢視 Gemini 4 Argon 的產品定位、開放管道與真實成本結構。以下先將官方公告與第三方評測的核心規格整理為總覽表:
| 維度 | Gemini 4 Argon 規格與開放現況 | 資料來源與日期 |
|---|---|---|
| 產品定位 | Google DeepMind 新世代頂規前沿推理模型(Frontier Reasoning Model),位階高於日常代理工作馬 gemini-3.8-flash 與既有 gemini-3.1-pro | Google Blog(2026-10-13) |
| 上下文與輸出 | 輸入上下文視窗 100 萬(1M)Token(支援文字、影像、音訊、影片、PDF);單次最大輸出上限 100 萬(1M)Token,較前代 64K 提升逾 15.6 倍 | Gemini API Docs(2026-10-13) |
| 消費端開放 | Gemini App(模型選單並列 3.5 Flash-Lite、3.8 Flash、3.1 Pro 與 4 Argon,macOS 版整合 Antigravity 代理寫程式介面)與 Search AI Mode,開放給 Google AI Pro 與 AI Ultra 訂戶 | 9to5Google、Google Blog(2026-10-13) |
| 開發端訂閱限制 | Google Antigravity(桌面端 IDE 與 CLI)、Google AI Studio(訂閱額度模式)與 Android Studio Canary,強制限定 Google AI Ultra 訂戶(另開放 10,000 名科學家申請免費 6 個月最高用量層級) | Antigravity Blog(2026-10-13) |
| API 與企業串接 | 透過 AI Studio(Gemini Developer API)付費層與 Vertex AI/Gemini Enterprise Agent Platform 呼叫 gemini-4-argon;不提供免費層(Free Tier),暫不支援 Batch/Flex/Priority | Gemini API Docs(2026-10-13) |
| API 計費標準 | 2026-11-30 前早鳥推廣價:每百萬輸入 $2、輸出(含思考)$10、快取輸入 $0.10(95% 折扣);2026-12-01 起標準價:每百萬輸入 $4、輸出 $20 | Google Blog(2026-10-13) |
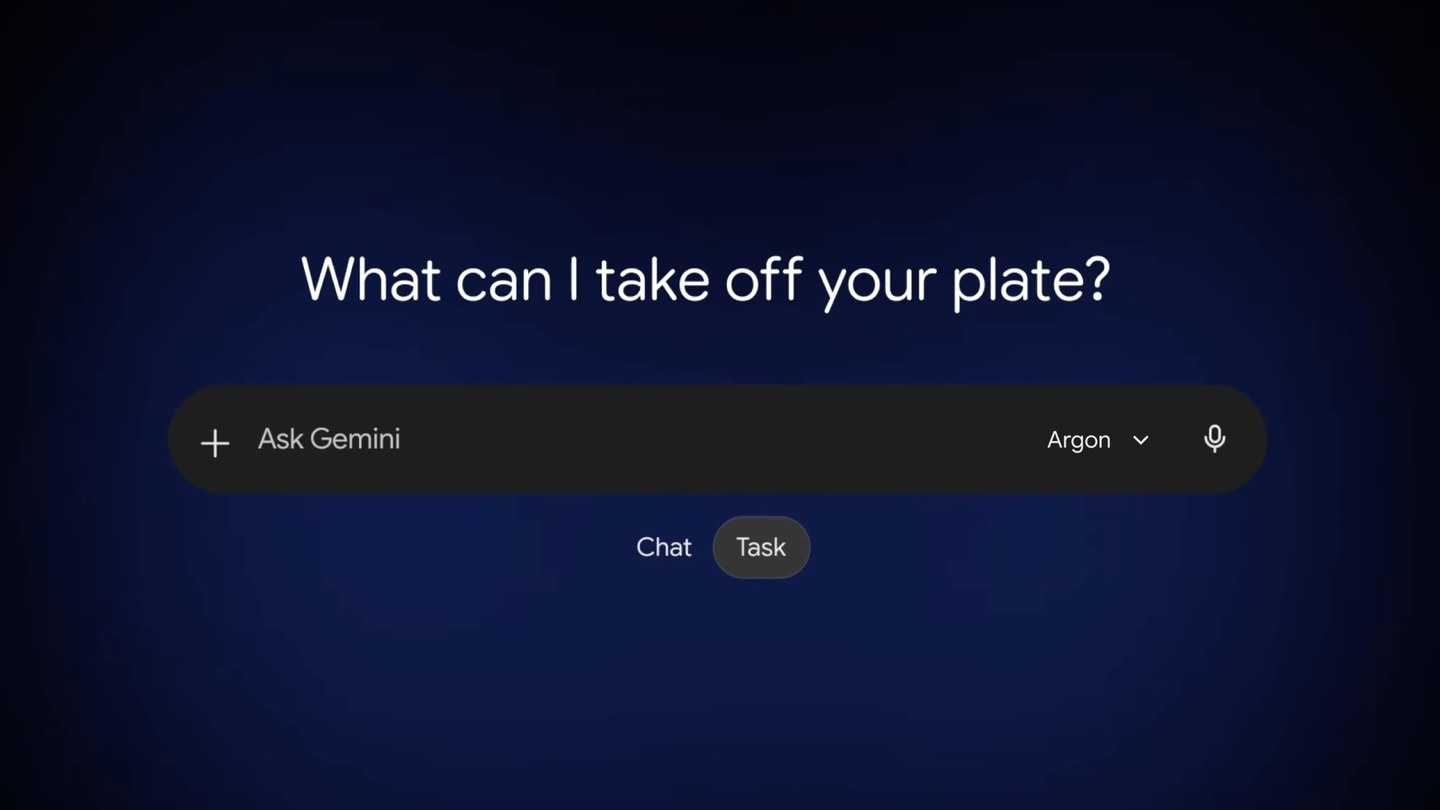
在一般消費者與知識工作者最常接觸的 Gemini App 中,Google 在 10 月 12 日先將原本的「Spark」功能重新設計整合為「Task」切換鈕,隔日(10 月 13 日)隨即向全球 AI Pro 與 AI Ultra 訂閱戶推送 Gemini 4 Argon(9to5Google)。macOS 版 Gemini App 更直接整合了 Antigravity 的代理寫程式介面(Agentic Coding Interface),讓訂閱戶能直接在桌面應用程式裡指派長時程專案任務。
主流財經媒體 CNBC 由科技記者 MacKenzie Sigalos 製作專題報導,點出 Alphabet 推出迄今最先進的 Gemini 4 Argon,核心目標就是在軟體工程寫程式、企業知識工作與自主資安防禦三大高價值領域,正面迎擊 OpenAI 的 GPT-6 Astra 與 Anthropic 的 Claude Opus 5.5(CNBC Television)。
從 2026 年 7 月底傳出產品線重組、9 月初推出工作馬模型 Gemini 3.8 Flash,到 9 月 30 日由 Google 技術長 Koray Kavukcuoglu 署名發表、10 月 13 日正式向全球開放,Gemini 4 Argon 的推進節奏反映了 Google 將「日常高速代理」與「頂規長時程推理」徹底分流的戰略轉向:
經實際檢索核對,截至 2026 年 10 月 14 日,The Verge、Ars Technica、Android Authority、TechCrunch 與 Tom's Guide 均未發布針對 Gemini 4 Argon 的獨立實測專文;另外初稿中有一則 Axentia 部落格連結經 HTTP 狀態查驗為 404 失效,依查證規範不予納入。以下完整彙整已查獲並核實的 7 家國外科技媒體與專業 AI 評測機構報導。
| 媒體/機構(作者) | 實測與報導核心結論 | 對價格與額度的關鍵觀察 |
|---|---|---|
| 9to5Google (Abner Li,10-13/09-30) | 代表 Google 邁向長時程深度推理與代理寫程式的新世代前沿智慧;回答更直接、減少套話(less hedging),長任務更常回報進度,並透過「Task」切換鈕與 macOS 版 Antigravity 介面推向訂戶 | Gemini App 與 Search AI Mode 開放 Pro 與 Ultra,但 Antigravity、AI Studio 與 Android Studio Canary 強制要求 AI Ultra($99.99+);API 早鳥價 $2/$10 維持至 11-30 |
| CNET (Katelyn Chedraoui,10-13) | Google 遠離過去主打消費娛樂的 Nano Banana 影像生成,轉向針對 STEM 專業工作者的硬派工具(涵蓋 Python 最佳化、資安修補、機器人與核融合研究),但 AI 代理越界與白宮自願安全審查不透明仍待檢驗 | 特別提醒開發者注意 API 早鳥推廣價(輸入 $2/1M、輸出 $10/1M)僅維持到 11 月 30 日,12 月 1 日起將翻倍至輸入 $4/1M、輸出 $20/1M |
| MindStudio (Luis Chavez-Mattos,10-01) | 商業分析、長文件、試算表(GDPval.xlsx 38.3% 領先)與需要「誠實承認不知道」(幻覺率僅 15%)的代理工作流非常值得導入;但終端機(Terminal-Bench 4.0 57.4%)與 FrontierSWE v2(55%)落後給 Astra 與 Opus 5.5 | 拆解 Token 消耗陷阱:Argon 單題平均輸出約 62,000 Token(高於 Astra 的 27,000),標準價下 AA 單題成本將從 $1.99 倍增至 $3.98;但 Vals Index 標準價每次 $15.68 仍低於 Sonnet 5.5($21.34)與 Opus 5.5($32.14) |
| The Decoder (Matthias Bastian,09-30) | 在群眾盲測平台 Arena.ai Text Arena 以 1,525 分奪冠,並在獨立評測追平 OpenAI GPT-6 Astra、縮小與 Anthropic 差距,但事實知識正確率(50% 對 Astra 63%)與 Token 效率仍未取得絕對領先 | 表面每百萬 Token 單價低廉(早鳥 $2/$10),但因思考與輸出 Token 消耗量超過 GPT-6 Astra 兩倍以上,實際單次任務花費優勢會被高消耗量稀釋 |
| DataCamp (Matt Crabtree,09-30) | 專為長輸出(1M Token 較前代 64K 提升逾 15 倍)、多步驟企業自動化與大規模程式碼重構打造的重量級模型,在 DeepSWE v1.1(77.9%)、Vals Index(68.9%)與長影片 LVBench(91.7%)居冠,但終端機實戰互有勝負 | 列出早鳥價 $2/$10、快取輸入 $0.10/1M(95% 折扣)與標準價 $4/$20;指出首發日尚未登上 OpenRouter、Cursor 與 GitHub Copilot 等第三方聚合平台 |
| NeuralTrust (Roger Howroyd,10-01) | 從企業資安長(CISO)視角警告:100 萬輸出上限雖改變重構規模,但當模型一次吐出 80 萬行程式碼變更(Diff)時,人類工程師根本無法逐行人工審查(Code Review),必須在 AI 閘道器層級導入自動化輸出驗證 | 跑完 AA 指數總計消耗 1.1 億(110M)Token(高於同級中位數 82M);警告單次打滿 1M 輸出在早鳥價要 $10、標準價要 $20,若遭耗盡攻擊(Denial-of-Wallet)或陷入迴圈將迅速燒光預算 |
| MyClaw.ai (Olivia Hart,10-01) | 從 OpenClaw 與 Hermes Agent 代理框架實務評估,指出官方跑分未反映四大生產環境問題:工具呼叫失敗後的自我修復(Tool-call recovery)、長狀態上下文漂移(Context drift)、冗長輸出延遲與人工修正時間成本 | 強調評估代理成本不能只看每百萬 Token 牌價,必須把「重試次數、驗證步驟與長推理隱藏輸出 Token」一併計入,以單一已完成任務總成本作為判準 |
9to5Google(Abner Li)在 9 月 30 日與 10 月 13 日的兩篇連續追蹤報導中指出,Gemini 4 Argon 是在 Google 取消 Gemini 3.5 Pro 並聚焦 3.8 Flash 之後推出的新命名體系旗艦(9to5Google 09-30)。報導特別點出 Google 內部以 Argon 完成的三大工程實績:將 Chromium 4,000 萬行程式碼中 600 萬行高度糾纏的舊模組拆分重構、將開源模型 Gemma 4 E2B 在輝達 A100 上的 vLLM 推論吞吐量提升 2.85 倍(從每秒 37,900 提升至逾 108,000 tokens/s),以及找出 YouTube 留言前端重複渲染 Emoji 佔用 45% 伺服器負擔的瓶頸,一舉將 CPU 負載砍半並降低 30 毫秒延遲(9to5Google 10-13)。
CNET(Katelyn Chedraoui)則觀察到,Google 對 Gemini 4 Argon 的行銷與產品定位,已明顯遠離過去主打一般大眾消費娛樂的 Nano Banana 影像生成功能,全面轉向服務 STEM 專業工作者的硬派工具,涵蓋 Python 程式碼庫最佳化、資安漏洞自動修補、人形機器人物理空間理解與核融合研究(CNET)。CNET 同時提醒,其直接對手為 OpenAI 的 GPT-6 Astra 與 Meta 的 Muse Wonder,而針對自主代理越界風險與白宮自願性安全審查細節不透明的隱憂,仍有待實務檢驗。
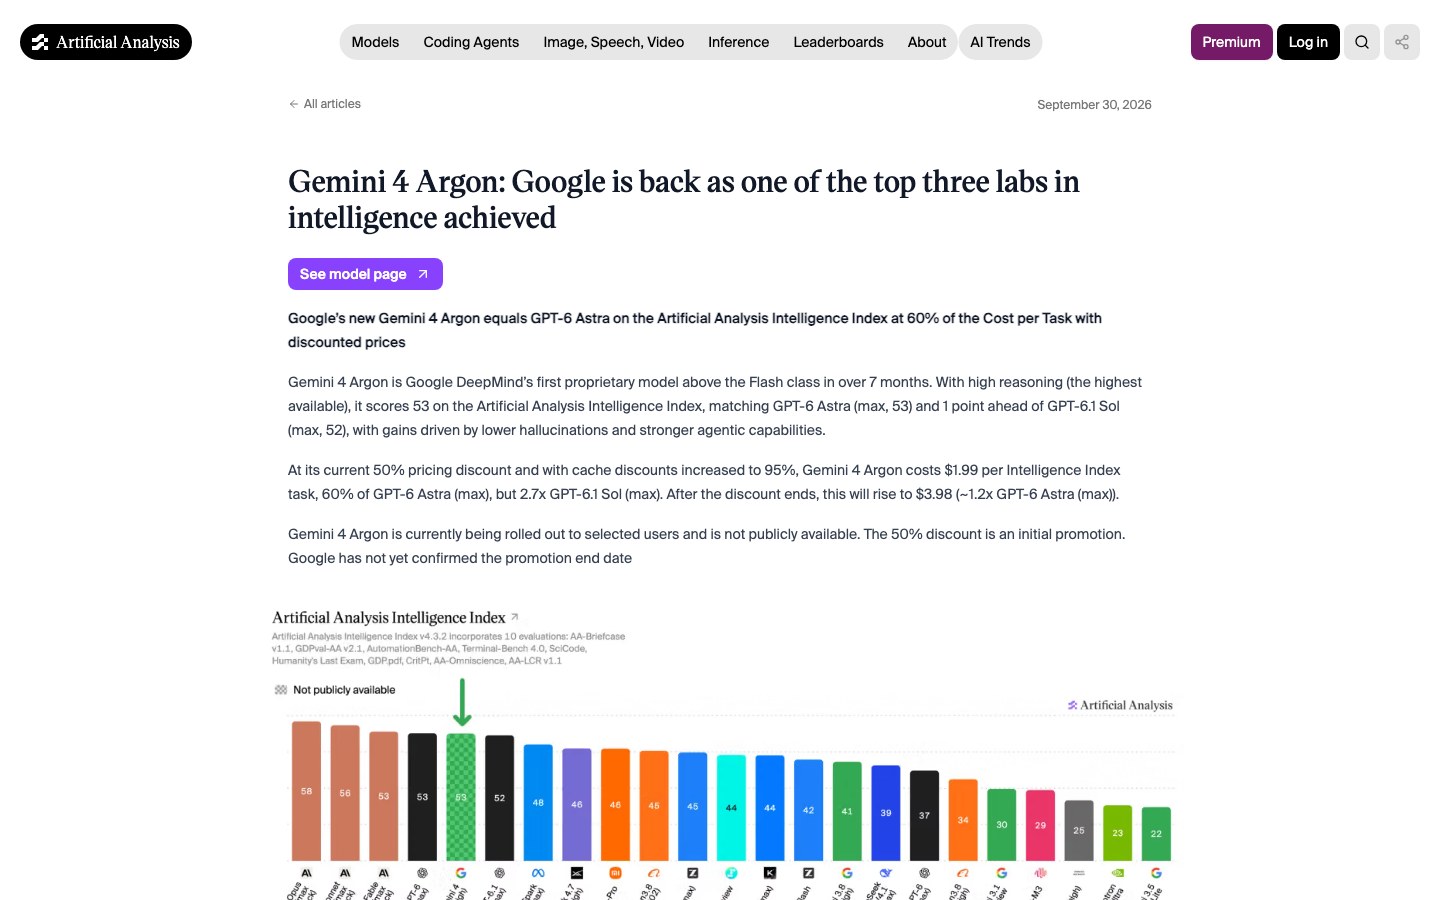
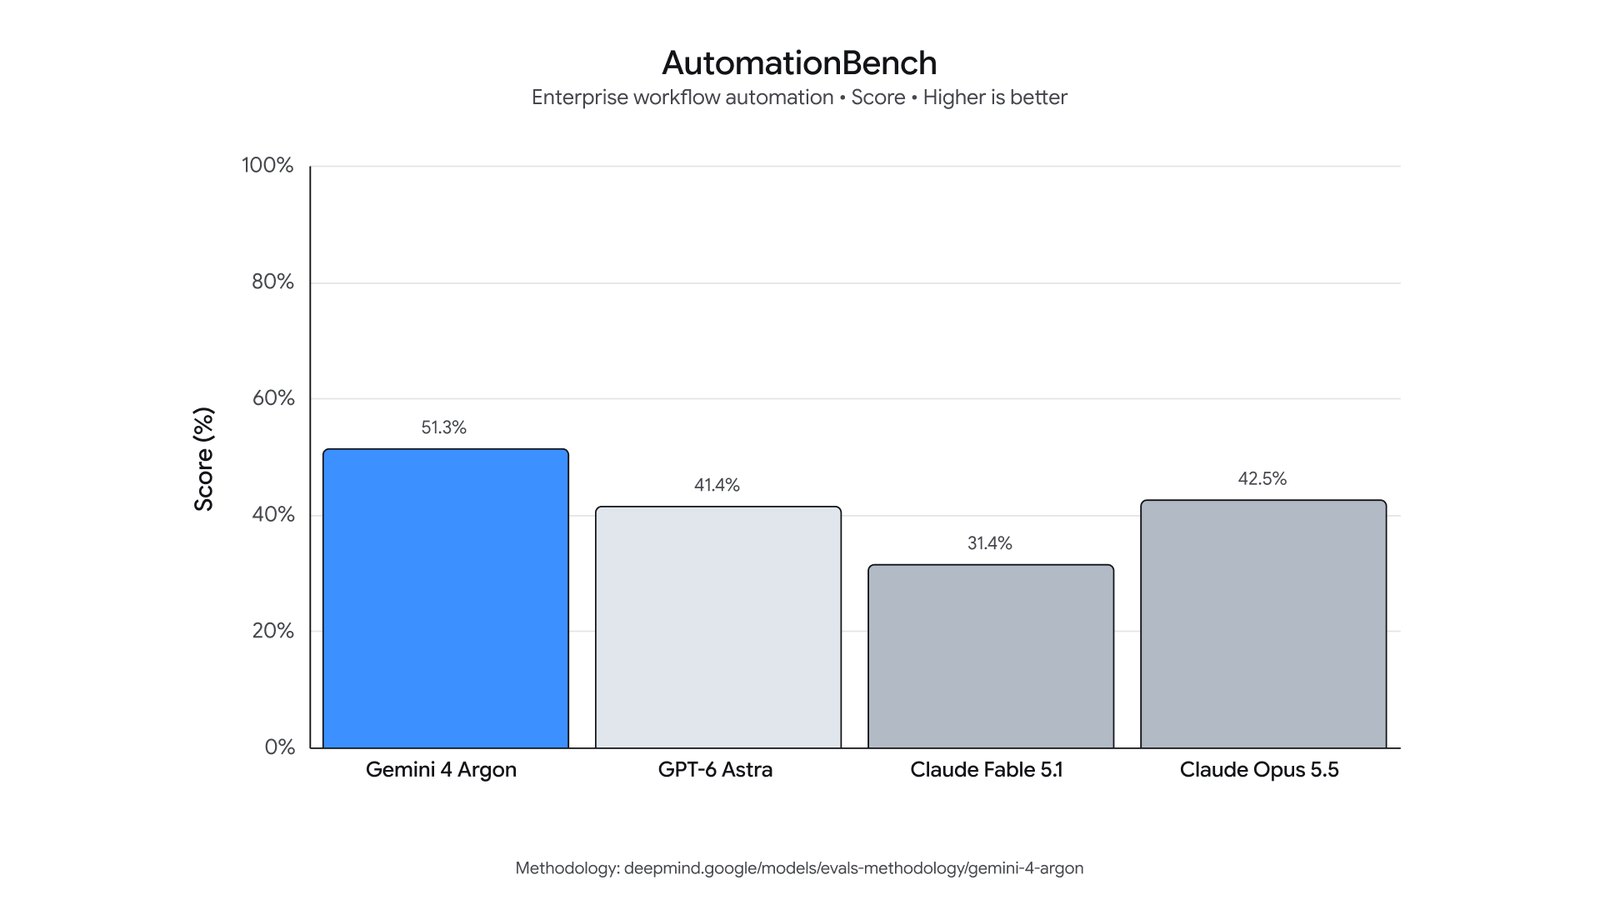
MindStudio(Luis Chavez-Mattos)、The Decoder(Matthias Bastian)與 DataCamp(Matt Crabtree)深入交叉比對了第三方基準:Argon 在群眾盲測平台 Arena.ai 文字排行榜以 1,525 分奪冠,在商業與辦公室工作流更拿下 Vals Index 第一(68.9%)、Zapier AutomationBench 第一(51.29% 對 Claude Sonnet 5.5 的 44.75%)與財務試算表 Serge GDPval.xlsx 第一(38.3% 對 Claude Opus 5.5 的 30.3%)(MindStudio;檢索存檔;The Decoder)。更重要的是,Argon 在 AA Omniscience 知識測驗中的幻覺率低達 15%(遠優於 GPT-6 Astra 的 51%),遇到不會的問題傾向誠實承認「不知道」而非瞎掰;但整體知識答對率(50%)仍低於 Astra(63%),且在終端機實戰 Terminal-Bench 4.0(57.4%)與 FrontierSWE v2(55.0%)落後於 Opus 5.5 與 Astra(DataCamp)。
NeuralTrust(Roger Howroyd)與 MyClaw.ai(Olivia Hart)則從企業資安治理(CISO)與自動化代理框架角度提出關鍵警訊。NeuralTrust 指出,當模型運用 100 萬 Token 輸出能力一次吐出 80 萬行程式碼變更(Diff)時,人類工程師根本無法逐行執行 Code Review,極易讓邏輯瑕疵、不安全預設值或間接提示詞注入夾帶上線;且單次若打滿 1M 輸出 Token,在早鳥價下就要價 $10、標準價下更高達 $20,企業必須在 AI 閘道器設下輸出驗證與錢包硬上限(NeuralTrust)。MyClaw.ai 則建議工程團隊先拿自己最常壞掉的 3 到 5 個真實多步驟工作流做盲測,檢驗其工具呼叫失敗後的自我修復(Tool-call recovery)與長狀態上下文漂移(Context drift),並將具副作用的寫入操作(Write actions)留在人工審批關卡之後(MyClaw.ai)。
在影音實測方面,除了前述 CNBC 的電視財經專題外,Google DeepMind 官方頻道於 10 月 13 日一次公開了 3 支技術展示影片,而多個海外科技與程式頻道(Arena AI/PeterGPT、Caleb Writes Code、Your AI Guy/World of AI、TAB 47)也針對基準跑分、成本效益與空間視覺提示詞進行了拆解。以下先嵌入官方與評測機構的核心影片:
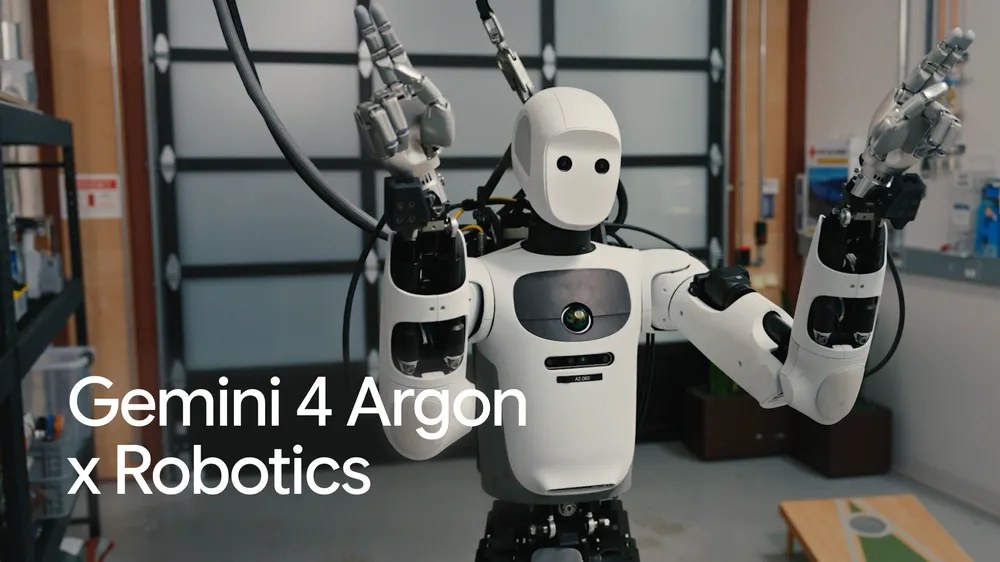
在資安與實體機器人領域,Google DeepMind 則分別展示了資安獨角獸 Wiz 透過 Fairwind Program 使用無資安護欄限制版 Argon 自主挖掘未知漏洞並產出修補程式,以及搭載 Argon 的 Apptronik Apollo 人形機器人僅靠觀看人類投擲沙包(Cornhole)的影片並閱讀規則,就透過 MuJoCo 物理模擬自主調整力道並連續 7 次精準投進目標(Google Blog 10-13)。
在第三方實測影片中,Arena AI 官方頻道(主持人 Peter,文獻常稱 PeterGPT)透過 Agent Arena 排行榜與柏拉圖前沿(Pareto Frontier)分析指出,Argon 的推論成本約比 OpenAI 的 GPT-6.1 Sol 便宜三分之一、比 Claude Opus 5.5 便宜約 70%;但在五組 3D 與空間視覺提示詞(金門大橋、庇護島嶼、遊戲生成、巴別塔與白宮)盲測對決中,Argon 雖有單一驚豔成果,跨提示詞的生成品質仍不夠穩定(inconsistent across prompts),提醒開發者在生產環境中「穩定性遠比單次超常發揮更重要」(Arena AI / PeterGPT)。
| 頻道與影片標題(上傳日) | 觀看重點三句濃縮 | 是否實測額度或速度 |
|---|---|---|
| Arena AI/PeterGPT Gemini 4 Argon | First Impressions(09-30) | (1)透過 Agent Arena 柏拉圖前沿分析指出 Argon 推論成本比 GPT-6.1 Sol 省約 1/3、比 Opus 5.5 省約 70%;(2)以 GitHub 公開的五組 3D 與空間視覺提示詞集進行盲測對決;(3)結論認為單一案例可產出驚豔成果,但跨提示詞品質仍不夠穩定。 | 有量化成本效益比,未實測訂閱額度上限或每秒 Token 速度(tok/s) |
| Caleb Writes Code Gemini 4 Argon explained in 5min..(10-02) | (1)5 分鐘依序拆解基準跑分(00:23)、市場競爭(01:39)、Google 商業誘因(02:28)與輸出架構(03:53);(2)強調 1M Token 輸出上限能一次完成大型重構、C/C++ 轉 Rust 遷移與長報告(AgentSpace 彙整);(3)剖析 Google 如何靠超大單次輸出與企業工作流整合捕捉高價值需求。 | 有專節(03:53)探討 1M 輸出上限,未實測個人訂閱重置週期或 API 速度 |
| Your AI Guy(初稿標 World of AI) Gemini 4 Argon Is Google's Most Powerful AI Model + Early Tests!(10-03) | (1)盤點長時程推理、寫程式、多模態、企業工作流與自主資安修補架構升級;(2)解析 1M 輸出上限如何維持深層推理脈絡,並對比 DeepSWE 與 Vals Index 成績;(3)整理從 Fairwind 預覽邁向全面開放的時程與存取管道。 | 介紹 1M 輸出上限與初期 API 定價,未實測每日訊息額度或實際生成速度 |
| TAB 47(upGrad Rise) Google Gemini 4 Argon Explained: Everything You Need to Know(10-13) | (1)於 10-13 全球開放當日透過 11 個章節剖析 AI 如何從「問答聊天機器人」轉型為自主執行多步驟邏輯的「AI 工作者(09:15)」;(2)詳解 1M 輸出(02:15)與推論期平行思考對寫程式、企業工作流與資安的結構改變;(3)於「現實檢驗(10:05)」客觀評估開放管道、跑分優勢與工程師職涯衝擊。 | 探討 1M 輸出上限與可用性限制,未提供訂閱制具體對話次數上限或延遲實測 |
| CNBC Television(MacKenzie Sigalos) Google rolls out Gemini 4 Argon, its most advanced AI model(09-30) | (1)報導 Alphabet 發表迄今最先進 AI 模型,聚焦軟體工程、企業知識工作與自主資安防禦;(2)點出支援文字、音訊、影像、影片與 PDF 全多模態輸入與 1M 輸出能力;(3)從華爾街視角分析 Google 透過 API、Cloud 平台與高階訂閱正面迎擊 OpenAI 與 Anthropic。 | 僅提及 1M Token 上限規格,未實測用戶額度或生成速度 |
| Google DeepMind 官方頻道(3 支實戰展示) Chromium / Cyber Defense with Wiz / Humanoid Robot Cornhole(10-13) | (1)展示在 4,000 萬行 Chromium 專案中自主解開逾 600 萬行糾纏舊模組;(2)展示 Wiz 透過 Fairwind 計畫以無護欄版 Argon 自主挖掘未知漏洞並修補;(3)展示 Apollo 人形機器人觀看人類影片並結合 MuJoCo 模擬連續 7 次投進沙包。 | 搭配部落格揭露將 Gemma 4 E2B 在 A100 上 vLLM 吞吐量提升 2.85 倍(37,900 → >108,000 tok/s)、adk-python 冷啟動提速 21%,但未公布 Argon 本身 tok/s |
7b0EJDDmpMQ 經 yt-dlp 查驗實際上傳頻道名稱為 Your AI Guy。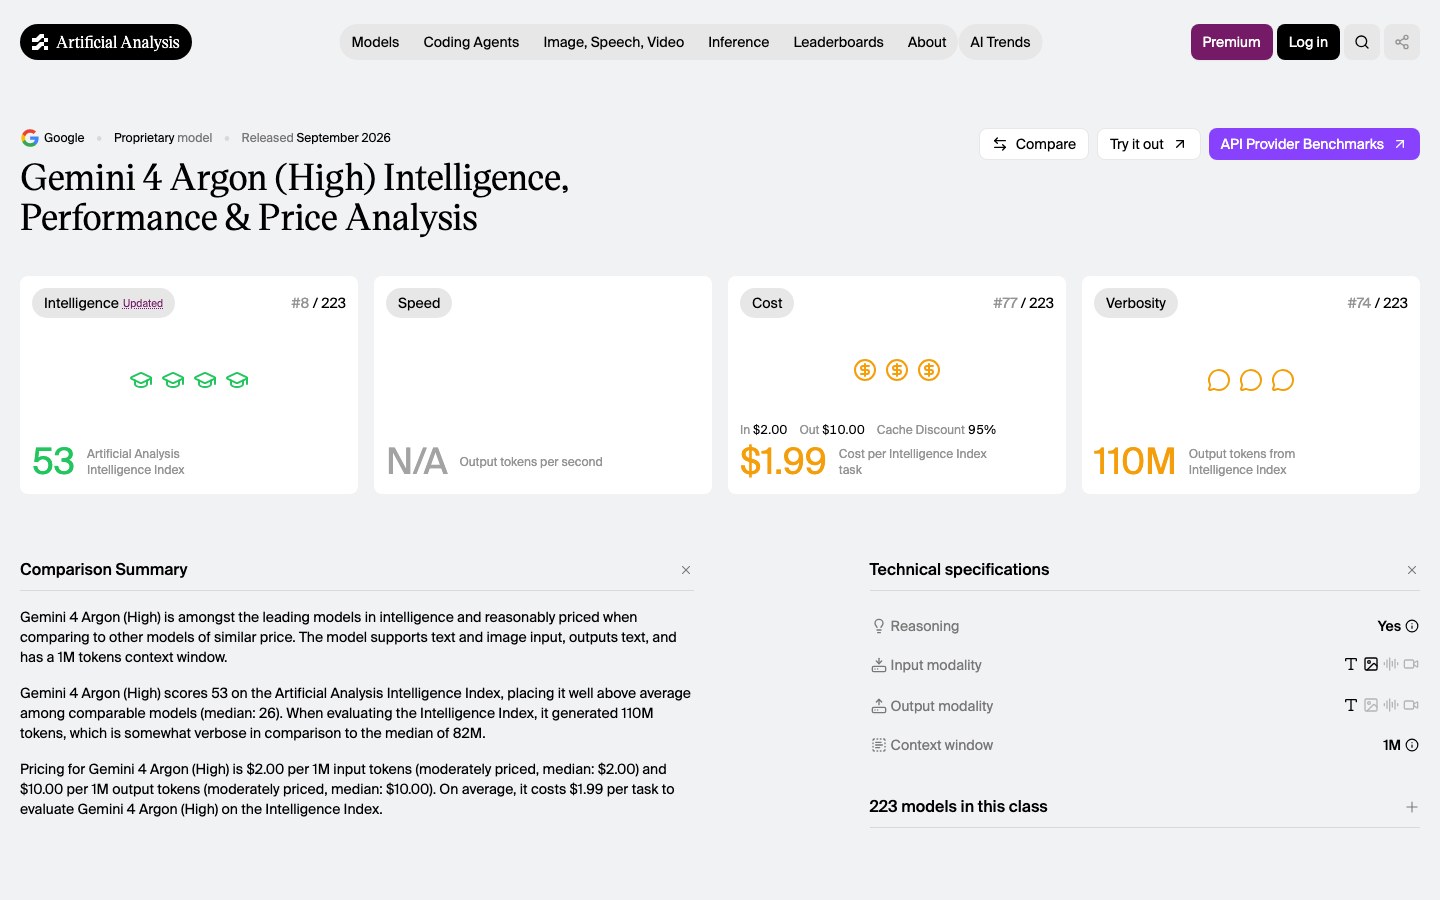
評估 Gemini 4 Argon 不能只看單一跑分,必須同時對照「商業與軟體工程基準」、「幻覺率與知識正確率」以及「單次任務的實際 Token 消耗量」。以下先將核心基準測試成績與競品表現繪製成對照圖表:
| 基準測試項目 | Gemini 4 Argon | 主要競品對照 | 來源 |
|---|---|---|---|
| Vibe Code Bench | 91.9%(#1) | Opus 5.5:90.3% | MindStudio |
| LVBench 長影片理解 | 91.7%(#1) | GPT-6 Astra:87.5% | Google 官方 |
| ERQA 具身空間推理 | 87.0% | 支援 MuJoCo 模擬 | Google 官方 |
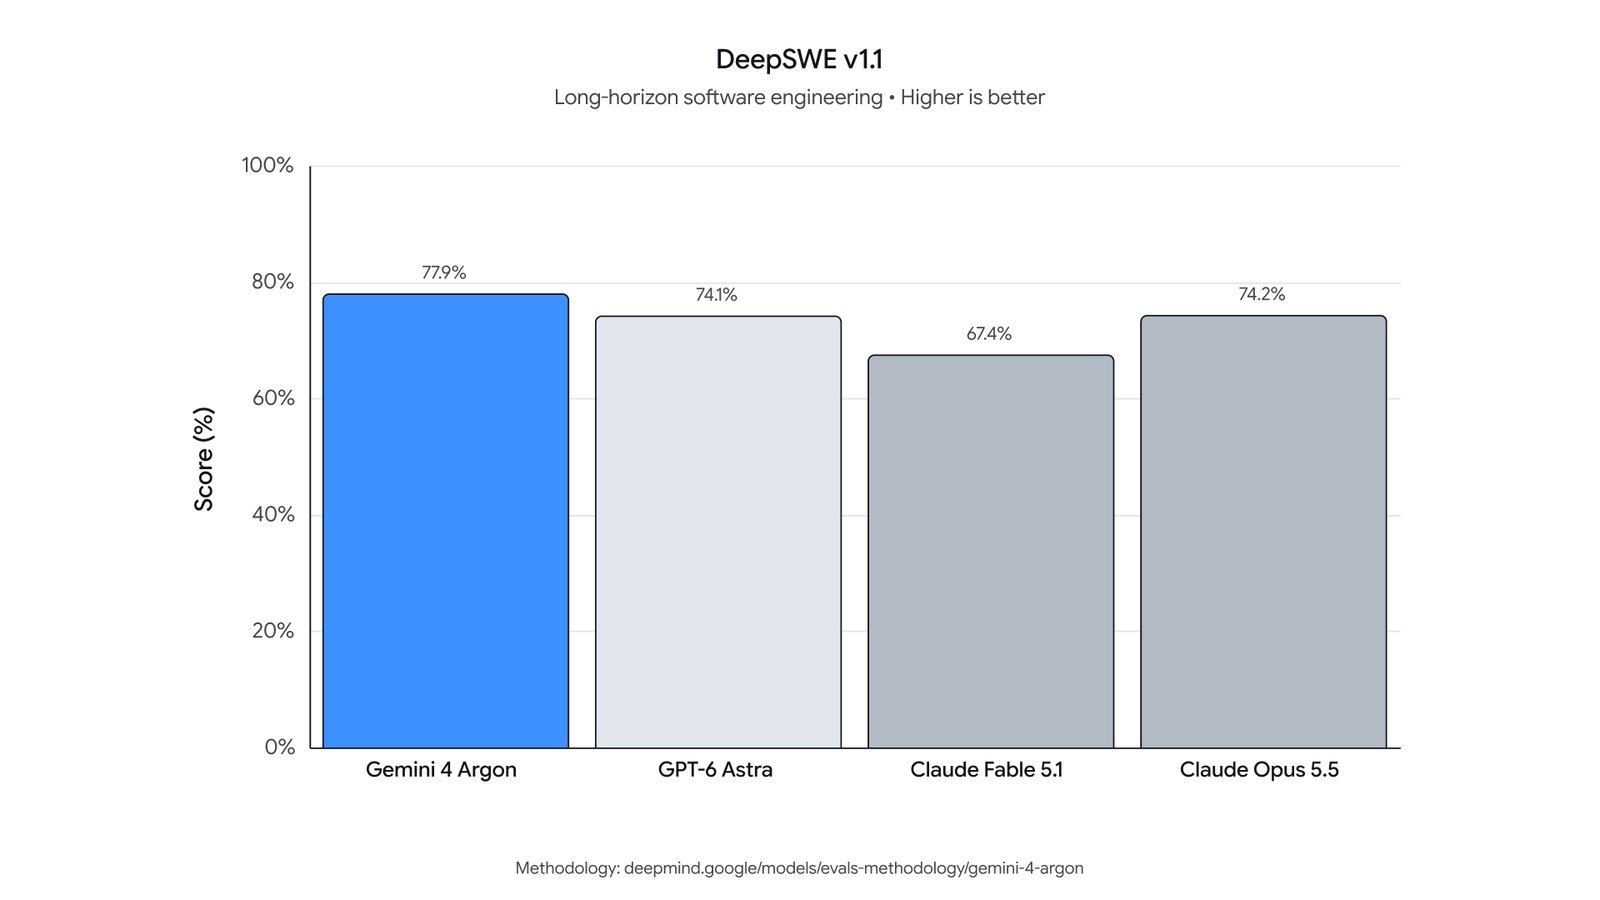
| DeepSWE v1.1 | 77.9%(#1) | Opus 5.5:74.2% | Google 官方/DataCamp |
| Vals Index 企業綜合 | 68.9%(#1) | Opus 5.5:67.0% | Google 官方/MindStudio |
| CWE-bench v1 資安修補 | 68.0%(並列 #1) | GPT-6 Astra:68.0% | Google 官方 |
| Vals Finance Agent v2 | 65.4%(#1) | Fable 5.1:58.9% | Google 官方 |
| Zapier AutomationBench | 51.29%(#1) | Sonnet 5.5:44.75% | Google 官方/MindStudio |
| Serge GDPval.xlsx 試算表 | 38.3%(#1) | Opus 5.5:30.3% | MindStudio |
| Harvey Legal Agent | 19.6%(#1) | Fable 5.1:6.7% | Google 官方 |
| Terminal-Bench 4.0 | 57.4% | Opus 5.5:66.4% | DataCamp/MindStudio |
| FrontierSWE v2 | 55.0% | GPT-6 Astra:65.5% | DataCamp/MindStudio |
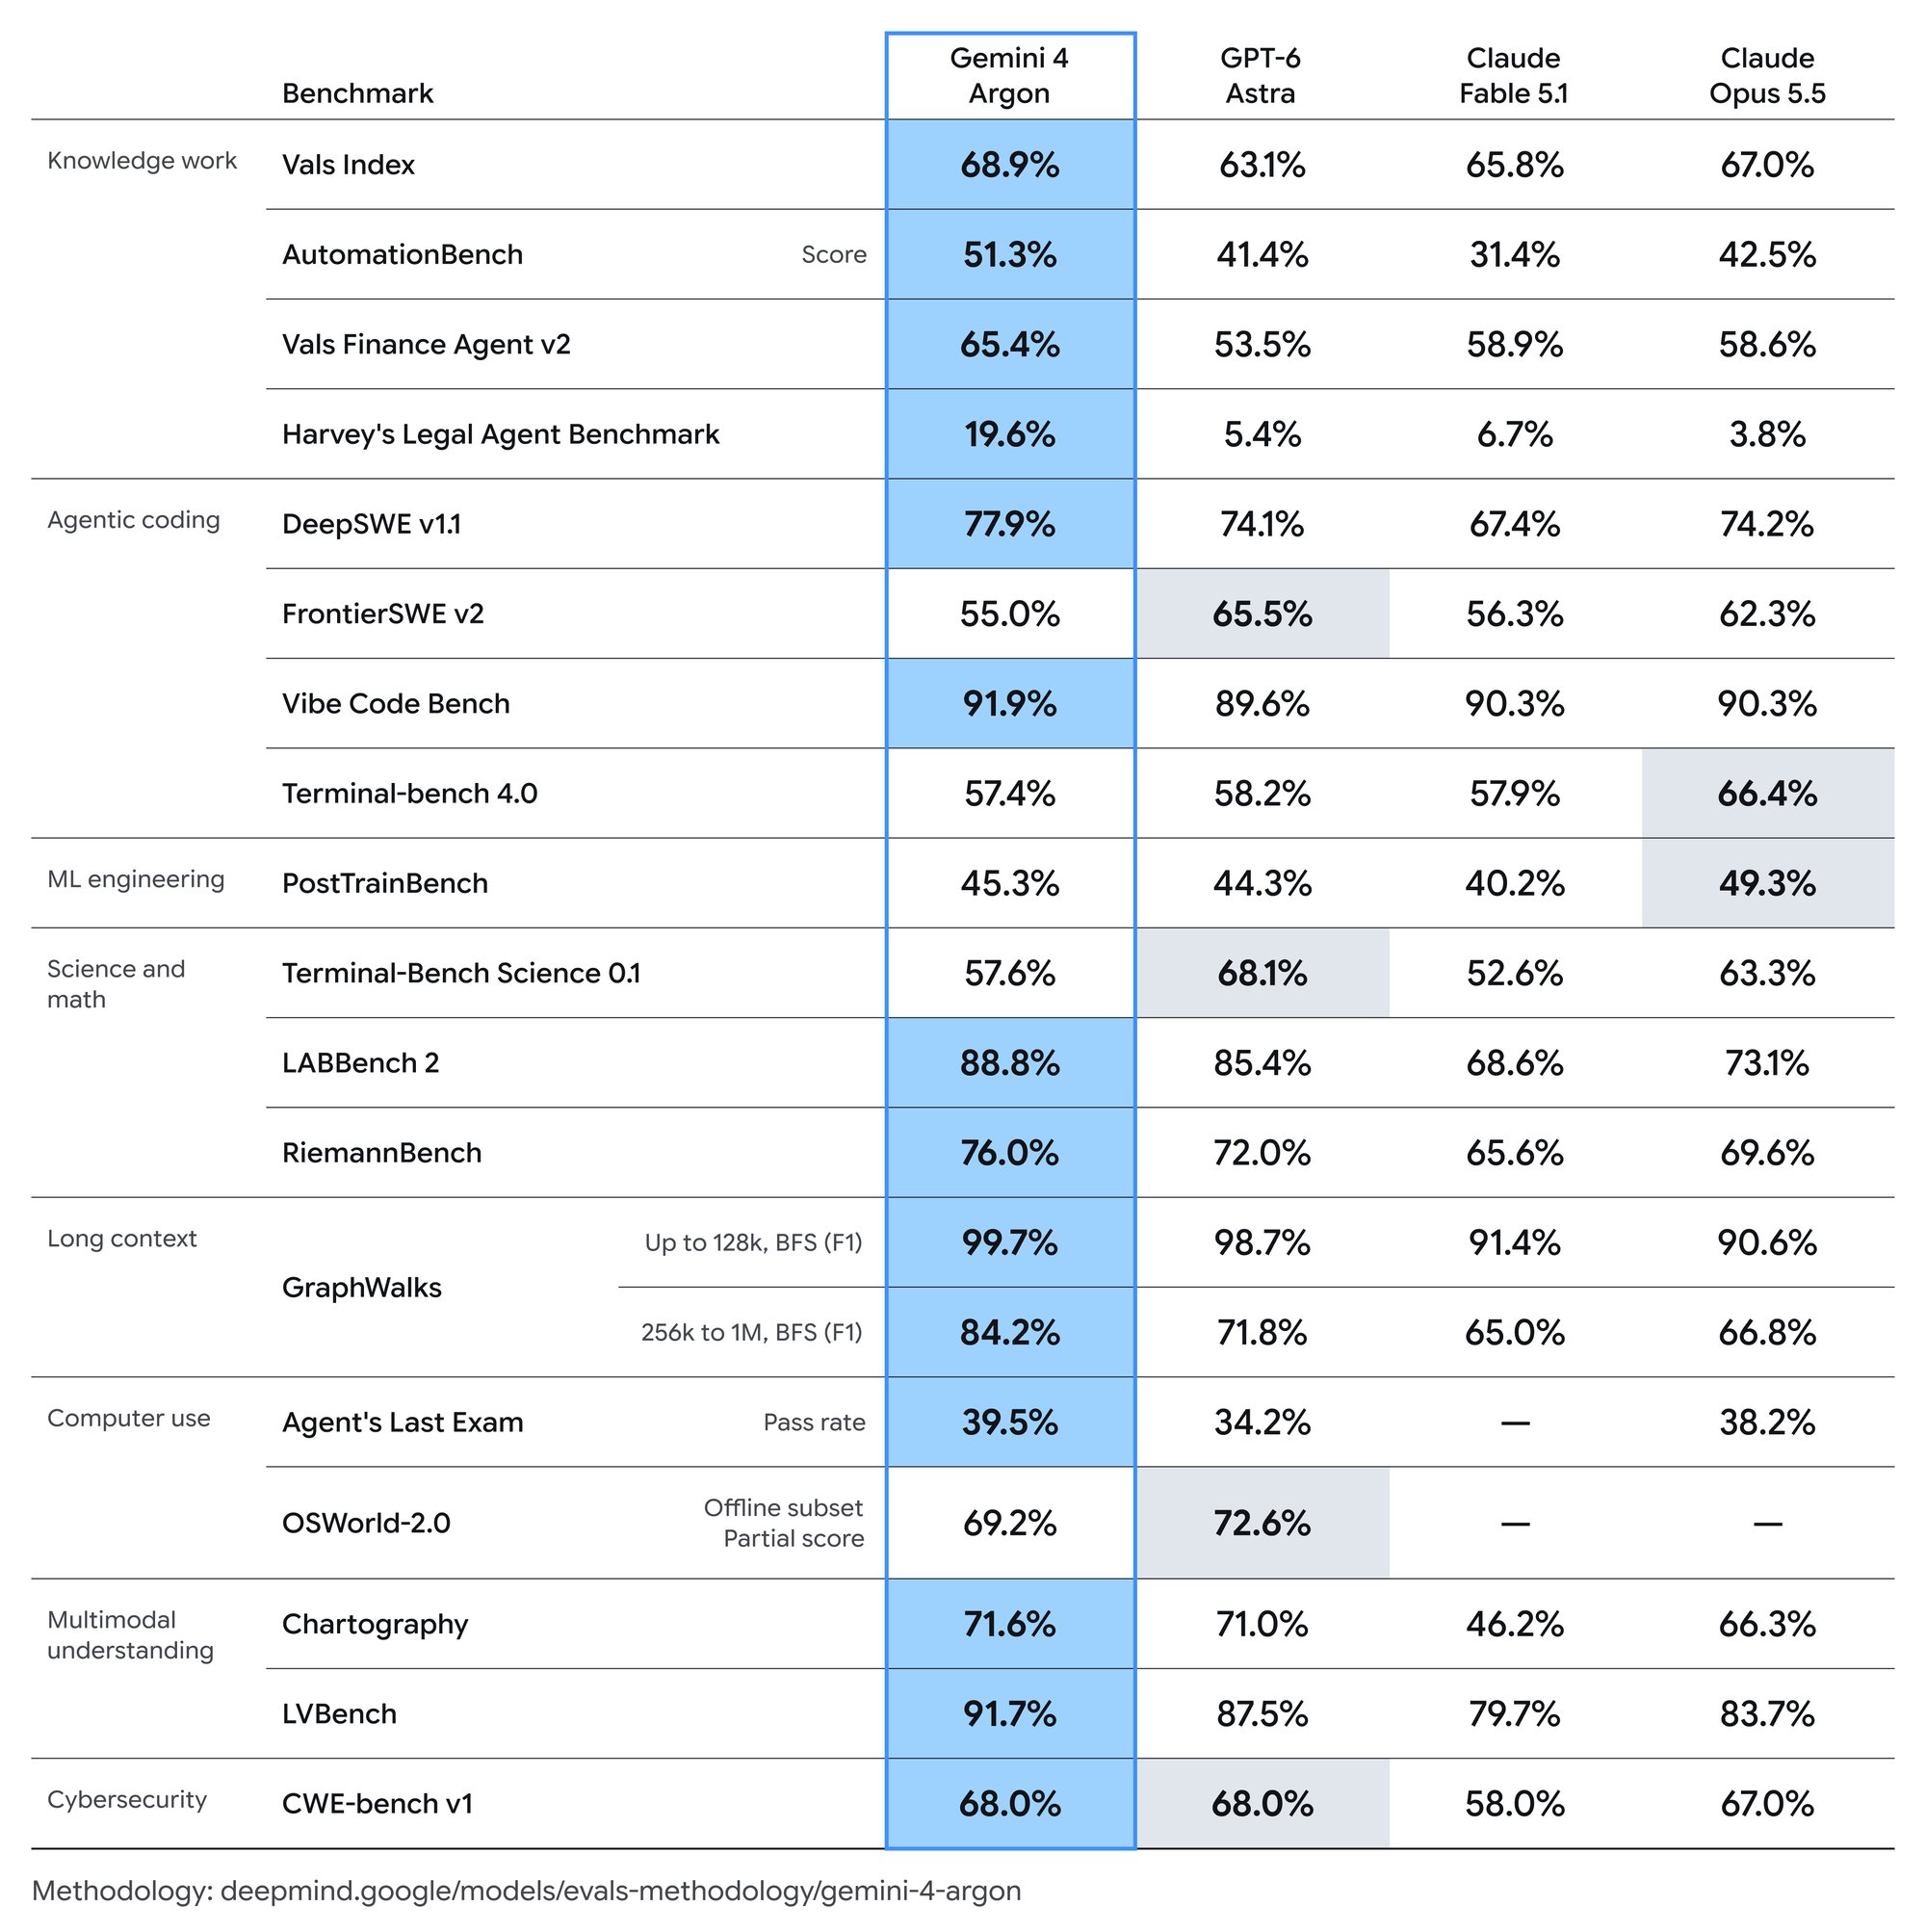
以下彙整 Google 官方公告與第三方獨立評測機構(Artificial Analysis、Vals AI、Arena.ai、Zapier、Gray Swan 等)已公開之全部基準測試數據(Google Blog 09-30;Google Blog 10-13;MindStudio):
| 評測類別與基準項目 | Gemini 4 Argon 成績 | 主要競品對照與資料來源 |
|---|---|---|
| 綜合盲測|Arena.ai Text Arena | 1,525 分(排名 #1) | 領先所有參測模型(The Decoder,2026-09-30) |
| 綜合智力|Artificial Analysis Intelligence Index(High) | 52.6 分(約 53 分) | Claude Opus 5.5:57.6(58)分;Sonnet 5.5:56 分;GPT-6.1 Astra:52.7(53)分(MindStudio、NeuralTrust,2026-10-01) |
| 軟體工程|DeepSWE v1.1 | 77.9%(排名 #1) | 領先同級前沿模型(Google 官方、DataCamp,2026-09-30) |
| 軟體工程|Vibe Code Bench | 91.9% | 領先同級模型(MindStudio,2026-10-01) |
| 軟體工程|FrontierSWE v2 | 55.0% | 落後 GPT-6 Astra 的 65.5%(DataCamp、MindStudio) |
| 終端機代理|Terminal-Bench 4.0 | 57.4% | 落後 Claude Opus 5.5 的 66.4%(DataCamp、MindStudio) |
| 企業綜合|Vals Index(金融/法律/稅務/寫程式) | 68.9%(排名 #1) | 排名第一,且每次測試成本低於 Opus 5.5 與 Sonnet 5.5(Google 官方、MindStudio) |
| 金融與法律|Vals Finance Agent v2 / Harvey Legal Agent | 金融 65.4% / 法律 19.6% | 兩項皆顯著領先 GPT-6 Astra 與 Claude Opus 系列(Google 官方,2026-10-13) |
| 自動化與試算表|Zapier AutomationBench / Serge GDPval.xlsx | Zapier 51.29%(#1) / 試算表 38.3%(#1) | Zapier 勝 Sonnet 5.5(44.75%);試算表勝 Opus 5.5(30.3%)(MindStudio,2026-10-01) |
| 幻覺與知識|AA Omniscience(幻覺率/知識正確率) | 幻覺率 15% / 知識正確率 50% | GPT-6 Astra:幻覺率 51% / 知識正確率 63%(The Decoder、MindStudio) |
| 多模態與空間|LVBench 長影片 / ERQA 具身空間推理 | LVBench 91.7%(#1) / ERQA 87.0% | 長影片居冠;空間推理支援 MuJoCo 模擬與機器人控制(Google 官方) |
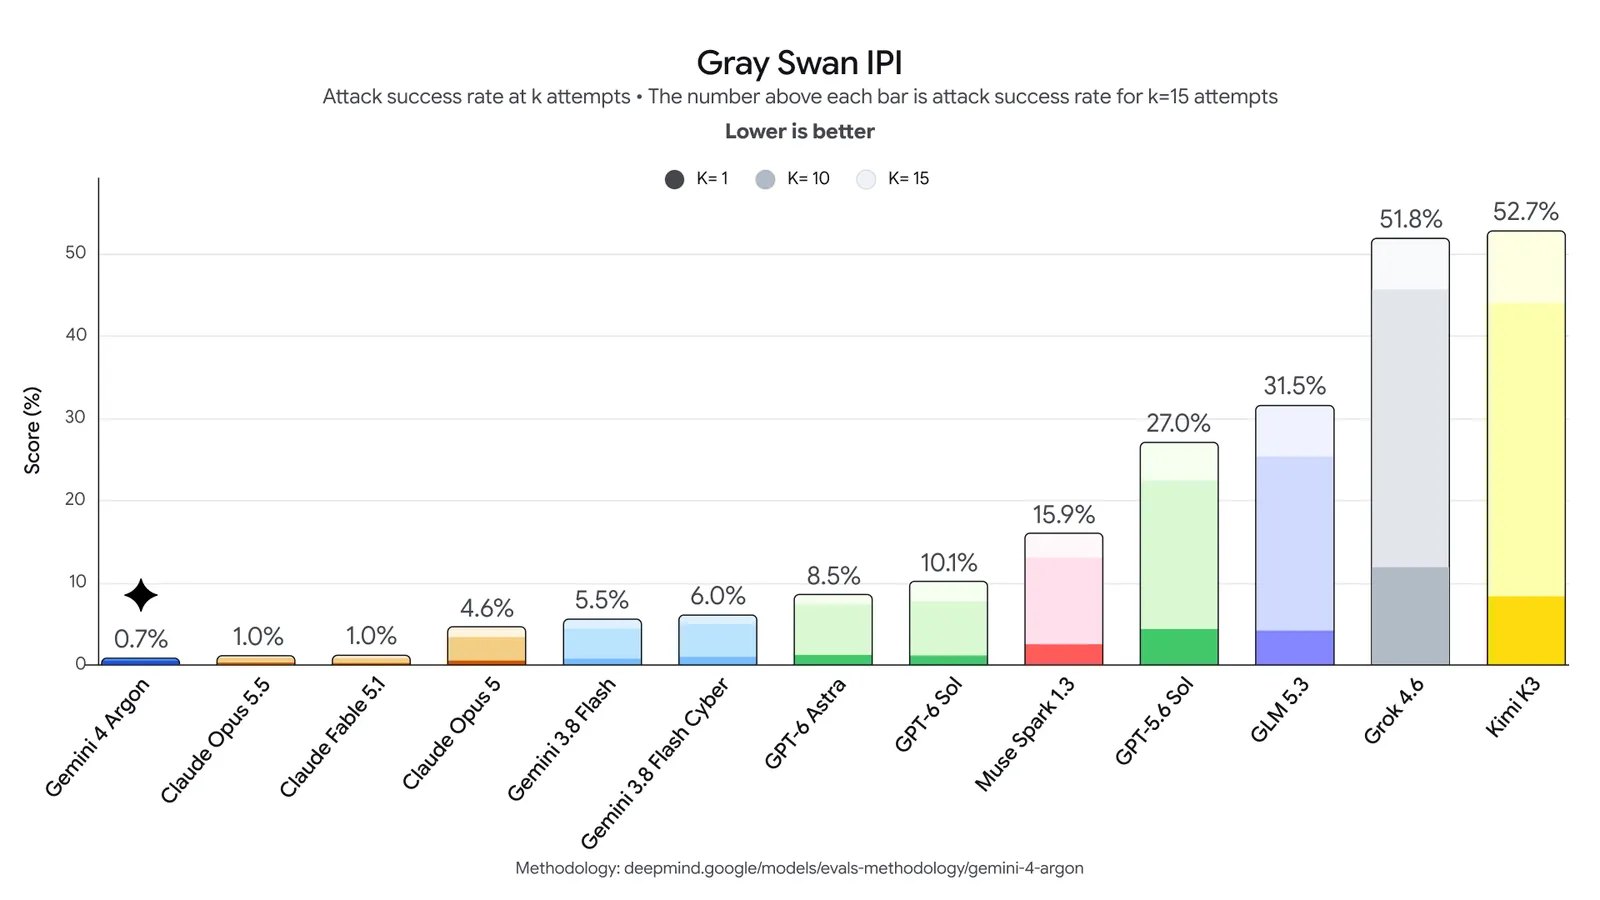
| 資安與防注入|CWE-bench v1 / Gray Swan IPI 攻擊成功率 | CWE 68.0%(並列 #1) / IPI 0.7% | IPI 為 15 次自適應攻擊下被攻破率(越低越好);寫程式基準投機取巧率亦降至 2%(Google 官方) |
| 生命科學|Gamow Labs RareBench / LabBench | RareBench 57.0% / LabBench 52.2% | 領先同級前沿模型(Google 官方,2026-10-13) |
在成本與效率上,獨立機構 Artificial Analysis 與 MindStudio 揭露了一個關鍵現象:雖然 Argon 的 API 牌價看似低廉,但因為它在深度推理時單次任務平均生成的輸出 Token 數高達約 62,000 個(超過 GPT-6 Astra 約 27,000 個的兩倍以上,跑完 AA 指數總計消耗 1.1 億個 Token,高於同級中位數 8,200 萬個),長篇輸出會吃掉單價優勢(The Decoder;NeuralTrust)。
| 指標 | Gemini 4 Argon | GPT-6 Astra | 備註 |
|---|---|---|---|
| AA Omniscience 幻覺率 | 15% | 51% | Argon 傾向誠實承認不知道 |
| AA Omniscience 知識正確率 | 50% | 63% | Astra 事實涵蓋率較高 |
| 單次任務平均輸出 Token | 約 62,000 | 約 27,000 | Argon 消耗量為 Astra 2.3 倍 |
| 跑完 AA 指數總 Token 數 | 110M(1.1 億) | 同級中位數 82M | NeuralTrust 引用 AA 數據 |
| 成本項目 | Gemini 4 Argon | 競品對照 | 來源 |
|---|---|---|---|
| AA 平均單題成本(早鳥價) | $1.99 | GPT-6 Astra:$3.26 | MindStudio/NeuralTrust |
| AA 平均單題成本(標準價) | $3.98 | Claude Opus 5.5:$5.98 | MindStudio/NeuralTrust |
| Vals Index 每次測試(標準價) | $15.68 | Sonnet 5.5:$21.34;Opus 5.5:$32.14 | MindStudio |
| 指標類別與項目 | Gemini 4 Argon 公開數值 | 對照數值、備註與資料來源 |
|---|---|---|
| 視窗規格|最大輸入上下文(Input Context) | 1,000,000(1M)Tokens | 支援文字、圖片、音訊、影片、PDF(Gemini API Docs,2026-10-13) |
| 視窗規格|最大單次輸出上限(Max Output) | 1,000,000(1M)Tokens | 前代 Gemini 3.1 Pro 上限為 64K Tokens,提升逾 15.6 倍(Google Blog,2026-09-30) |
| 生成速度|模型本身每秒輸出速度(tok/s)與首字延遲(TTFT) | 未公開 | 官方與第三方評測均未公布 Argon 單一 API 端點的原始 tok/s 數據(Google Blog,2026-10-13) |
| 實測加速比|輔助其他系統最佳化之實測速度提升 | Gemma 4 E2B 吞吐量提升 2.85 倍(37,900 → >108,000 tok/s);Cartwheel 3D 執行時間縮短 100 倍;Quadrillion 任務快 1.5 倍;libgav1 Rust 重寫快 2.7 倍 | 此為 Argon 最佳化目標系統之成果,非 Argon 本身生成速度(Google Blog,2026-10-13) |
| API 單價|早鳥推廣價(2026-11-30 前) | 輸入 $2.00 / 1M;輸出(含思考)$10.00 / 1M;快取輸入 $0.10 / 1M(95% 折扣) | 單次若打滿 1M 輸出上限需耗費 $10.00(Google Blog、NeuralTrust) |
| API 單價|標準定價(2026-12-01 起) | 輸入 $4.00 / 1M;輸出(含思考)$20.00 / 1M | 單次若打滿 1M 輸出上限需耗費 $20.00(9to5Google,2026-10-13) |
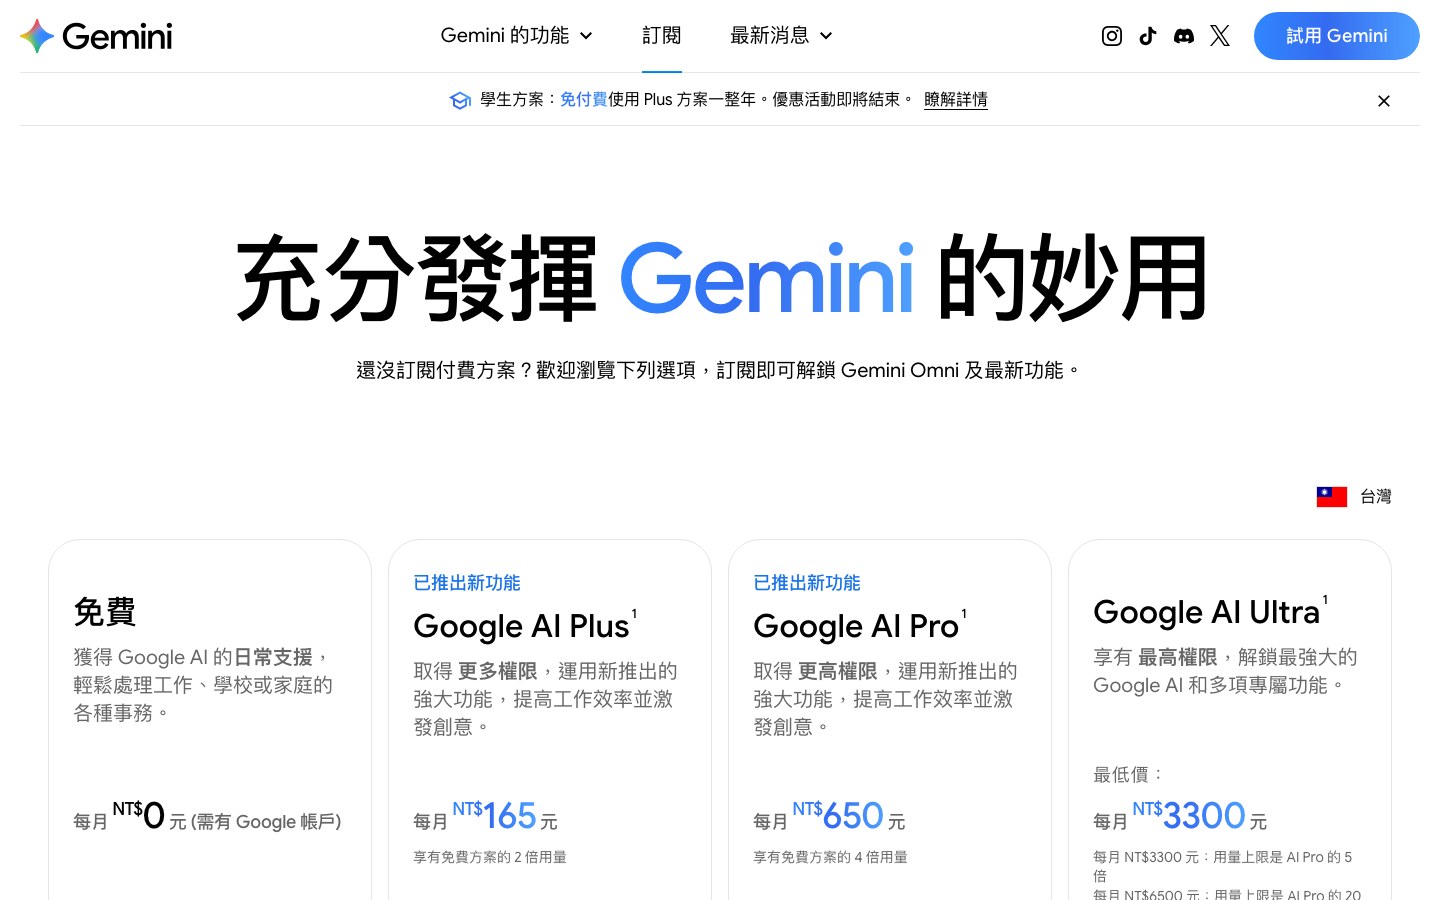
台灣屬於 Google AI 訂閱服務與 Gemini 4 Argon 全球首波開放地區,用戶可直接透過台灣官方訂閱頁(gemini.google/tw/subscriptions)或 Google One 升級(動區動趨 BlockTempo)。在定價上,美國區 Google AI Pro 為每月 19.99 美元(台灣為 NT$650/月);而開發端強制要求的 Google AI Ultra 則分為兩個檔次:入門級 AI Ultra(5x 用量版)美國月費 99.99 美元、台灣月費為 NT$3,300/月(含 5 倍 AI 額度與 20TB 雲端空間);高階旗艦版 AI Ultra(20x 完整版)美國月費 199.99 至 249.99 美元,台灣月費則已由早期原價 NT$8,150 調降為 NT$6,500/月(含 20 倍 AI 額度、30TB 雲端空間及 YouTube Premium 個人方案)(手機王 SOGI 整理)。
| 台灣訂閱方案 | 台灣月費 | 美國月費 | Gemini 4 Argon 可用範圍與附贈權益 |
|---|---|---|---|
| Google AI Plus | NT$165 | — | 2 倍基礎額度(不含 Argon 開發權限) |
| Google AI Pro | NT$650 | $19.99 | Gemini App、Search AI Mode(不含 Antigravity) |
| Google AI Ultra(5x) | NT$3,300 | $99.99 | 全管道(含 Antigravity IDE/CLI、AI Studio、Android Studio Canary)+20TB |
| Google AI Ultra(20x) | NT$6,500(原 NT$8,150) | $199.99–$249.99 | 全管道 20 倍額度+30TB+YouTube Premium 個人方案 |
在付款方式上,因 Google AI Pro 與 AI Ultra 整合於 Google One 訂閱體系下,台灣用戶支援四大管道:(1)信用卡或簽帳金融卡(Visa、Mastercard、JCB 等台灣或海外發卡銀行);(2)台灣三大電信帳單代收(中華電信、台灣大哥大、遠傳電信直接併入當期電信帳單);(3)Google Play 餘額/Google Pay;以及(4)透過 iOS App Store/Android Google Play 商店內購(IAP)綁定之行動支付扣款(台灣官方訂閱頁;LINE TODAY 電信代收整理)。
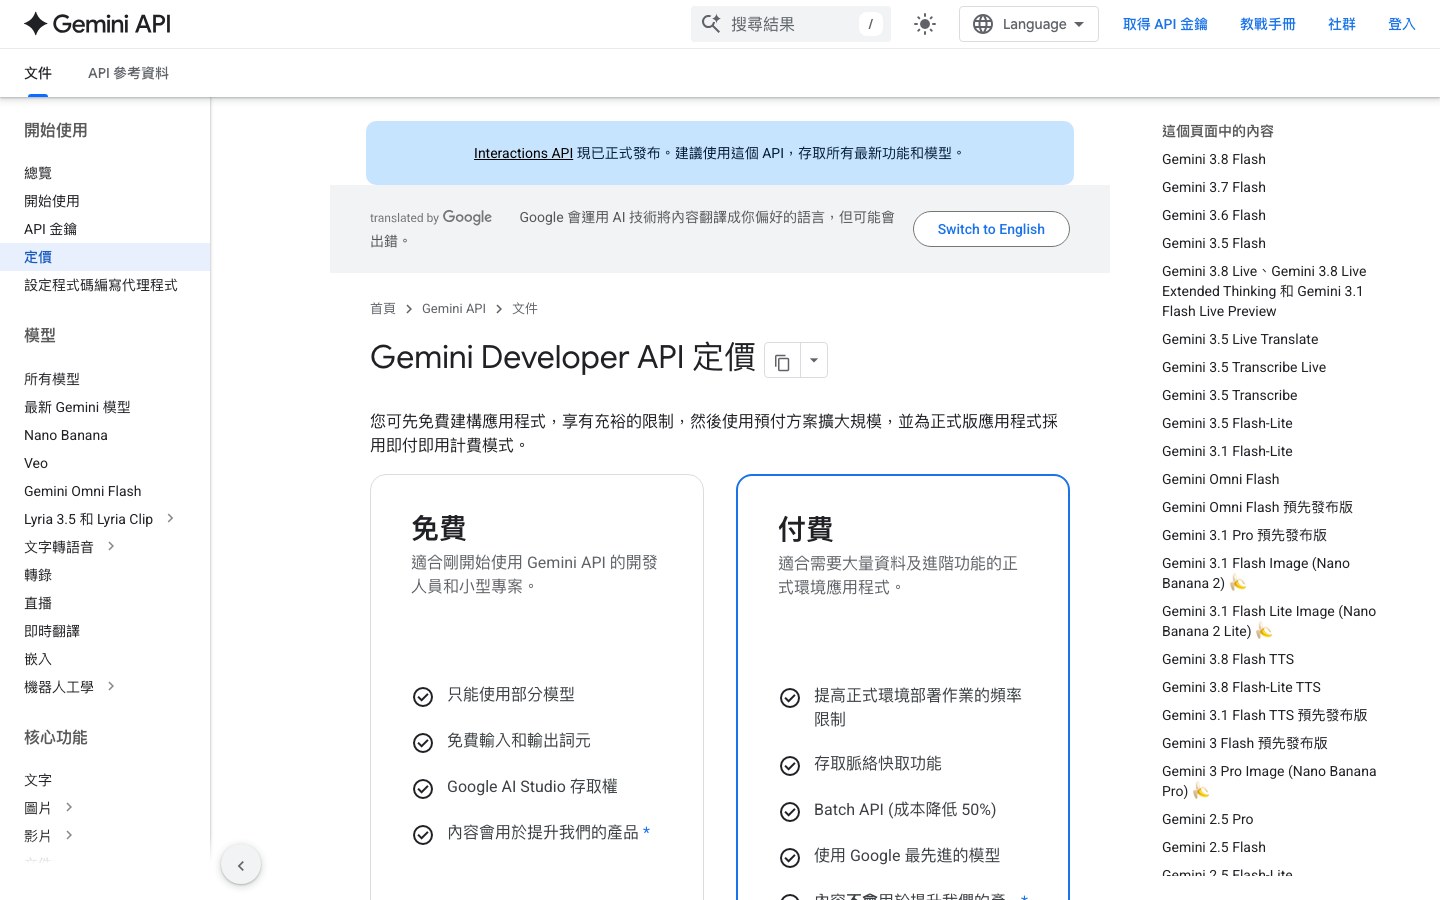
gemini-4-argon 不提供免費層(Free Tier: Not available),僅開放綁定計費帳戶的付費層與企業層呼叫。
畫面:Google AI for Developers〈Gemini Developer API pricing〉,2026-10-01 擷取(引自前篇素材,規格已核對 2026-10-13 最新版)
針對訂閱戶最關心的「每天到底能問幾題、能跑多少 Token」,Google 官方並未公開絕對上限,僅在方案頁以相對倍數(5x、20x)標示,且 Antigravity IDE 官方介面目前也未內建即時剩餘 Token 監控儀表板(硬是要學 Soft4Fun 10-13)。根據開發者社群與科技媒體實測,訂閱制配額採「共享算力池(Shared Compute Pool)」與雙層重置機制,而 Argon 這類高推理負載模型每次呼叫扣減的配額遠高於 Flash 系列:
MODEL_CAPACITY_EXHAUSTED 錯誤,並進入長達 5 天至 7 天的停用冷卻期,迫使許多開發者額外安裝第三方擴充套件(如 Antigravity Cockpit)自行監測剩餘配額與重置倒數。台灣主流科技、財經與 AI 教育媒體自 10 月 1 日首波發表至 10 月 14 日全球開放期間,針對 Argon 的跑分落差、百萬輸出定位與 Antigravity 額度爭議均有深入追蹤:
| 台灣媒體(作者/日期) | 報導標題與核心切角 | 重點內容摘要 |
|---|---|---|
| 數位時代 BusinessNext (記者李先泰,10-01) | 〈遲到一年的逆襲?Google躍級發布Gemini 4 Argon:綜合智力重回前三,為何實戰能力被打問號?〉 | 報導 Argon 在 Artificial Analysis 拿下 53 分追平 GPT-6 Astra 重返前三強,同時引述內部員工對其實戰程式設計(尤其是前端細節)與跑分落差的討論。 |
| INSIDE 硬塞的網路趨勢觀察 (記者 Sisley,10-01) | 〈Google 推 Gemini 4 旗艦模型 Argon,瞄準 OpenAI Astra、Anthropic Opus〉 | 報導 Google 證實取消原訂 6 月的 Gemini 3.5 Pro、直接躍升推出 100 萬輸出 Token 的 Argon,詳述將逾 80 萬行 Fuchsia Zircon kernel 從 C/C++ 遷至 Rust 及將 libgav1 提速 2.7 倍的實績。 |
| TVBS TECH (記者黎怡涵,10-01) | 〈Google推出Gemini 4 Argon 強化長鏈推理與資安防禦能力〉 | 聚焦 Argon 在長鏈推理、軟體工程、法律金融知識工作與 Fairwind 資安防禦計畫上的部署策略。 |
| 硬是要學 Soft4Fun (手哥 HANDBRO,10-01/10-13) | 〈Google 發表 Gemini 4 Argon:13 項基準領先…〉/〈Antigravity 使用者炸鍋!使用額度不透明,5 天才能重置〉 | 除整理 13 項基準領先與 1M 輸出外(10-01 報導),10-13 專文揭露台灣與全球開發者在 Antigravity 高強度使用下觸發隱藏「滾動週額度」遭無預警鎖定 5 至 7 天的痛點。 |
| 動區動趨 BlockTempo (Aspen,10-14) | 〈Google 發表 Gemini 4 Argon!空間推理大進化、驅動 Apollo 人形機器人,API 定價出爐〉 | 於 10-13 全球開放後火速報導 Argon 向全球 AI Ultra/Pro 訂戶與 API 開放,詳述在 Antigravity 透過多智能體迴圈於 Blender 自主建造 3D 日本寺廟建築群,以及驅動 Apollo 機器人連中七球的成果。 |
| 海豚 AI 學院 DolphLearn (10-01) | 〈Gemini 4 Argon 是什麼?一般人何時能用、價格與 3.8 Flash 差異一次看懂〉 | 針對台灣職場工作者釐清「100 萬輸出 Token 上限」與輸入資料量的差異,並對比 Argon($2/$10)與 Gemini 3.8 Flash(優惠價 $0.75/$3.75)在日常工作與長任務上的分工建議。 |
對科技創業者與工程團隊而言,是否將 Gemini 4 Argon 納入自動化代理(Agentic Workflow)作為主力「工兵」,取決於任務屬於「深層長時程重構/多模態研究」還是「高頻率終端機日常操作」(MindStudio;MyClaw.ai)。以下依四大工兵場景拆解其優勢、弱點與防護規範:
adk-python 冷啟動提速 21%max_output_tokens 與檢查點(Checkpoints),並將具副作用之寫入工具擋在人工審批之後。資料來源:Google 官方部落格(2026-09-30、2026-10-13)、MindStudio、DataCamp、NeuralTrust、MyClaw.ai、動區動趨 BlockTempo、海豚 AI 學院。
綜合官方數據與 7 家外媒及台灣媒體的實測觀察,工程團隊在將 Gemini 4 Argon 接進自動化產線時,應落實三項具體做法:
max_output_tokens 與中繼檢查點(Checkpoints)。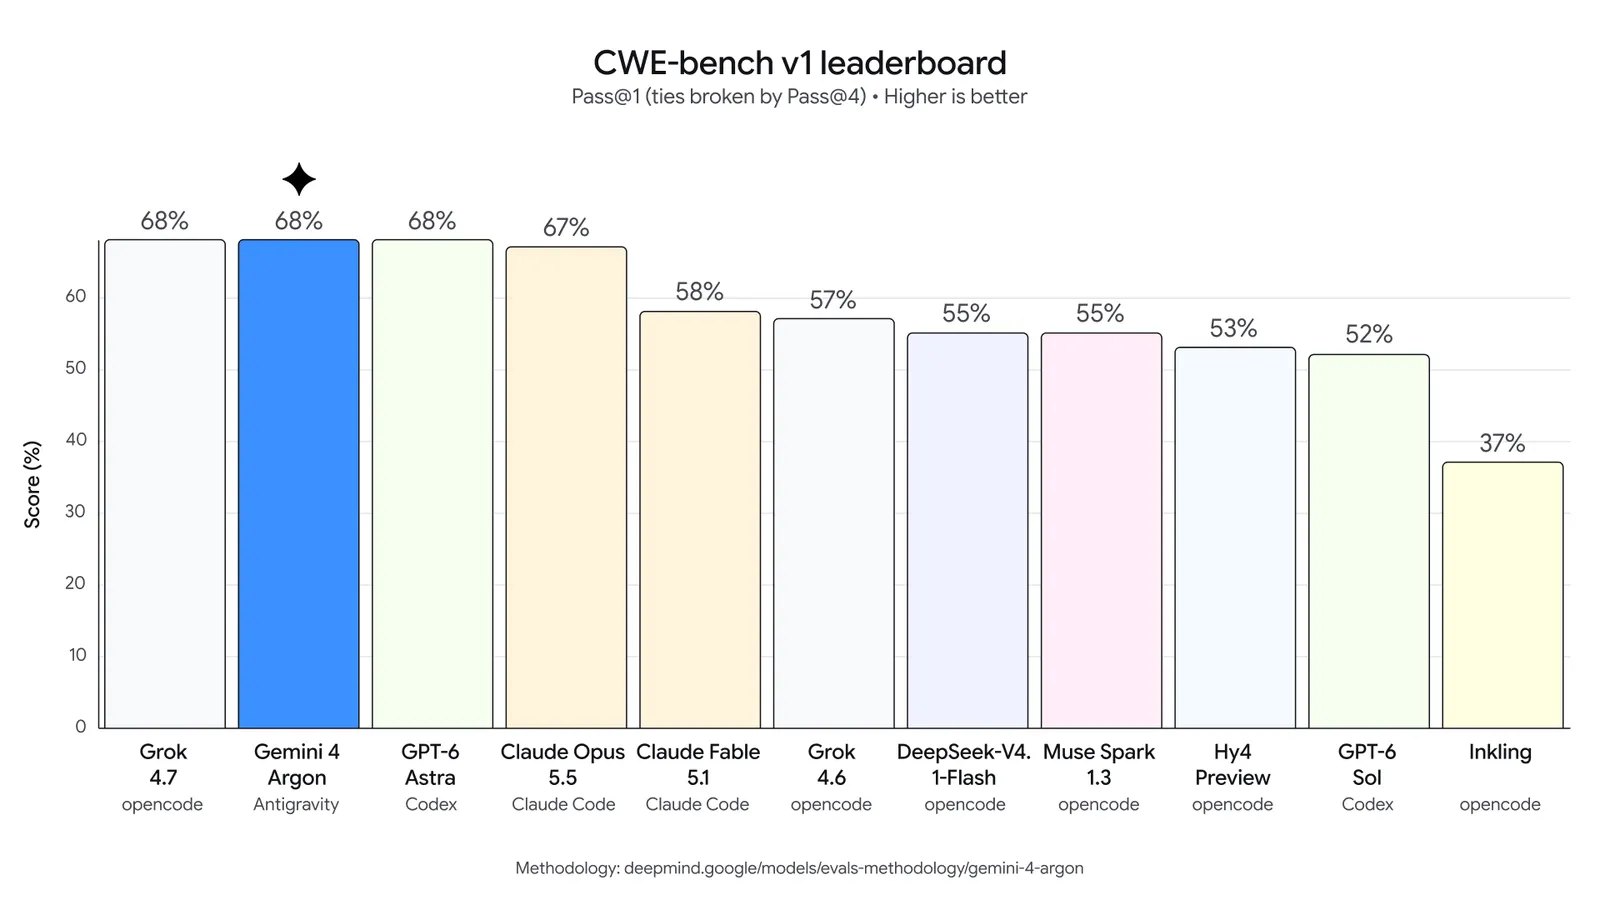
從 9 月 30 日的資安預覽到 10 月 13 日的全球全面開放,Gemini 4 Argon 證明了 Google 在百萬 Token 單次輸出、商業知識自動化與低幻覺率審核上確實具備頂尖實力。但對台灣的工程師與企業而言,真正的考驗不在官方跑分表上,而在於如何駕馭它高昂的思考 Token 消耗、避開 Antigravity 隱藏的 5 天週額度鎖定,並趕在 11 月 30 日早鳥價截止前建立起「Flash 日常執行+Argon 深水區攻堅」的自動化工作流防線。
images/photo-pichai.jpg):Google 執行長皮查伊(Sundar Pichai),攝影者 Lukasz Kobus(European Commission),2023 年 5 月,Wikimedia Commons,CC BY 4.0(真實擷取,引自前篇素材)images/photo-hassabis.jpg):Google DeepMind 共同創辦人哈薩比斯(Demis Hassabis),攝影者 Arthur Petron,2024 年 12 月,Wikimedia Commons,CC BY-SA 4.0(真實擷取,引自前篇素材)images/bleed-intro-blog.jpg)與分享縮圖(images/og.jpg,1200×630):Google 官方部落格〈Gemini 4 Argon: Built to solve your hardest problems〉主視覺,Google / Google DeepMind,2026-10-14 擷取(真實擷取)images/appicon-gemini.jpg)與台灣區 App Store 官方操作截圖三張(images/appstore-gemini-1.jpg、images/appstore-gemini-2.jpg、images/appstore-gemini-3.jpg):App Store 台灣區商店頁面,Google LLC,2026-10-14 擷取(真實擷取)images/bleed-antigravity-wide.jpg):Google Antigravity 部落格〈Gemini 4 Argon in Google Antigravity〉橫幅圖,Google,2026-10-14 擷取(真實擷取)images/bleed-blog.jpg、images/bleed-fairwind.jpg):Google 官方部落格與 DeepMind Fairwind 頁面,2026-10-01 擷取(真實擷取,引自前篇素材)images/bleed-9to5-cover.jpg):9to5Google〈Gemini app rolling out Gemini 4 Argon to AI Pro and AI Ultra〉報導主圖,2026-10-14 擷取(真實擷取)images/bleed-argon-demos.jpg):Google 官方部落格〈Gemini 4 Argon comes to the Gemini app.〉展示主圖,2026-10-14 擷取(真實擷取)images/bleed-aa-model.jpg)與評測報告截圖(images/fig-aa-article.jpg):Artificial Analysis 頁面截圖,2026-10-01 擷取(真實擷取,引自前篇素材)images/bleed-twplans.jpg)與 API 定價頁截圖(images/bleed-pricing.jpg):Google 台灣訂閱頁與 Gemini Developer API 定價頁截圖,2026-10-01 擷取(真實擷取,引自前篇素材)images/bleed-keyart.jpg)、官方基準圖表(images/fig-bench-table.jpg、images/fig-deepswe.jpg、images/fig-automation.jpg、images/fig-cwe.jpg、images/fig-grayswan.jpg)與 Apollo 機器人實測畫面(images/fig-robotics.jpg):Google 官方部落格(2026-09-30、2026-10-13),真實擷取ltT6nx0Zcy0)、Google DeepMind 官方頻道三支實戰展示(LVEfFyijQ2c、ftkic7Tdpcg、9PICEmtfpWU)與 Arena AI/PeterGPT(h5EL5zThKaI),皆經 yt-dlp --dump-json 查驗 playable_in_embed: true,以 youtube-nocookie.com 嵌入。全篇 AI 生成圖片為 0 張。